Jev Harness สำหรับ Claude Code และ Codex: Route, Permission, Verify ก่อนรัน
แปล Blueprint ของ Jev Harness ให้เป็นระบบ Coding Agent ที่ควบคุมได้: เลือก Context, Model, Tools และ Permission ต่อ Turn พร้อม Receipt และ Benchmark ที่ไม่หลงคำเคลม 200×
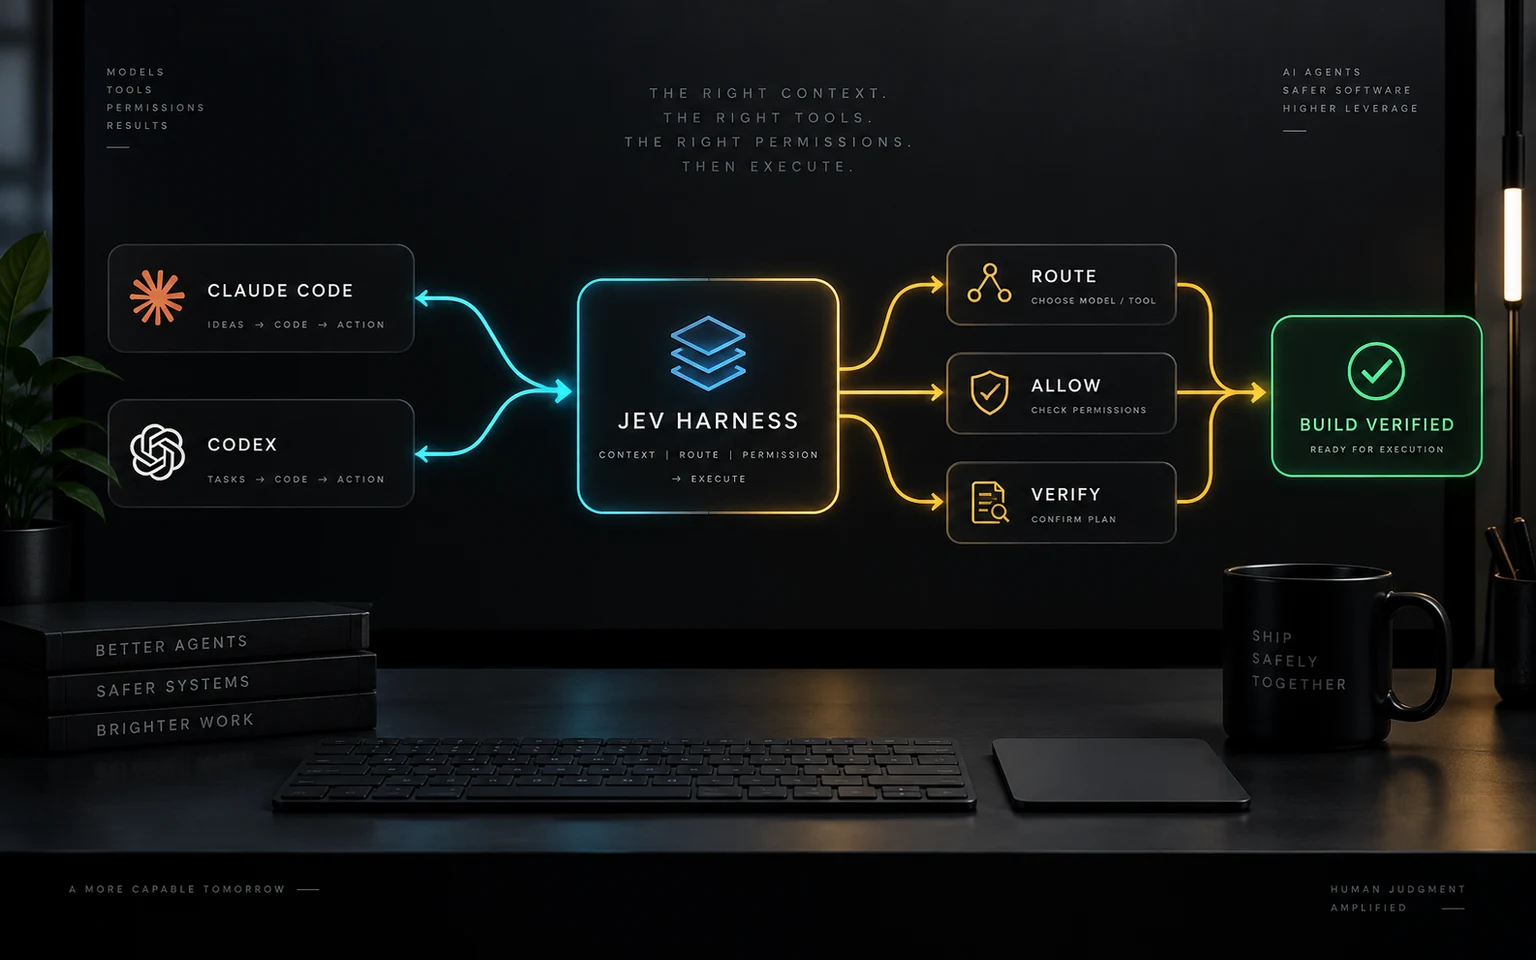
Jev Harness blueprint for coding agents
ดูโพสต์และวิดีโอต้นฉบับบน X
Agent Harness คือ Runtime รอบโมเดลที่เลือกว่าต่อ Turn ควรเห็น Context อะไร ใช้ Model/Tool ใด และ Action นั้นอนุญาตให้รันหรือไม่ แนวคิด Jev Harness เพิ่ม Decision layer ที่ตอบคำถามแคบและมีโครงสร้าง แล้วให้ Host code ตรวจ Policy และเก็บ Receipt ผู้ใช้ Claude Code หรือ Codex นำหลักนี้ไปใช้กับ Conditional instructions, Tool allowlist, Approval gates และ Evaluation ได้ แต่คำเคลม 200× เร็วขึ้น/400× ถูกลงยังต้องทดสอบกับงานจริง
- LLM เสนอ, Jev ช่วยตัดสินใจแคบ, Host code เป็นผู้อนุญาตและรัน
- ลด Context และ Tool schema เฉพาะเมื่อไม่ทำให้ความสามารถหาย
- แยก Route, Permission และ Verification ออกจากกัน
- Receipt คือหลักฐานการตัดสินใจ ไม่ใช่สิทธิ์ให้ Execute
- ทดสอบกับงานจริงแบบ Baseline → Shadow → Limited rollout
Harness คือระบบรอบโมเดล ไม่ใช่โมเดลใหม่
Coding Agent ไม่ได้มีแค่ LLM แต่ประกอบด้วย Context builder, Tool catalog, Permission policy, Executor, Sandbox, Memory และ Evaluation Harness จึงเป็นจุดที่ตัดสินว่า Agent เห็นอะไร ทำอะไรได้ และหยุดตรงไหน
Jev ถูกเสนอเป็น Decision layer สำหรับคำถามแบบเลือก Route, Tool, Risk หรือ Success โดย Host ยังคงเป็นผู้ถือ Policy และ Execution
สาม Decision ที่ควรแยก
- Context: ไฟล์ Instruction และ History ใดจำเป็นต่อคำถามนี้
- Route: Model, Skill, Sub-agent หรือ Tool ใดเหมาะกับงาน
- Permission: Action นี้ Allow, Ask หรือ Deny ภายใต้ Scope ปัจจุบัน
- Verify: Patch ผ่าน Typecheck, Test, Security และ Acceptance criteria หรือไม่
เริ่มใช้กับ Claude Code หรือ Codex โดยไม่สร้าง Platform ใหม่
หลักนี้ใช้ได้แม้ยังไม่มี Jev API เพราะประโยชน์แรกมาจากการทำ Decision และ Evidence ให้ชัดก่อน Automation
- เขียน AGENTS.md เป็น Source of truth ของคำสั่งและข้อห้าม
- แยก Instruction ตาม Directory และโหลดเฉพาะที่เกี่ยวข้อง
- ทำ Tool allowlist และขออนุมัติก่อน Network, Secret, Deploy หรือ Delete
- ให้ Agent เสนอ Plan/Patch ก่อน Execute
- รัน Build/Test และอ่านผลกลับหลัง Action
- เก็บ Task, Context version, Tool, Diff, Test result และ Reviewer เป็น Receipt
อ่านคำเคลม 200×/400× อย่างถูกต้อง
โพสต์ต้นทางสรุปว่า Blueprint ทำให้ Coding Agent เร็วขึ้น 200× และถูกลง 400× แต่แหล่งอธิบายที่ตรวจสอบได้ระบุว่านี่ไม่ใช่ end-to-end benchmark ของ Agent หลังติดตั้ง Harness ครบทุกขั้น
ค่าใช้จ่ายจริงต้องรวม Context rebuild, Cache, Routing overhead, Tool calls, Retry, Test และ Human review การเปลี่ยนไป Model ที่ถูกกว่าอาจแพงขึ้นหากต้องอ่าน Context ใหม่หรือแก้งานหลายรอบ
Rollout ที่ปลอดภัย: Baseline → Shadow → Limited
- Baseline: เก็บ Token, Latency, Tool use, Pass rate และ Human time ของระบบเดิม
- Shadow: ให้ Router แนะนำโดยยังไม่เปลี่ยน Execution
- Compare: ตรวจว่าตัด Context/Tool แล้วงานสำเร็จน้อยลงหรือไม่
- Limited: เปิดเฉพาะ Low-risk task พร้อม Cost cap และ Manual fallback
- Expand: เพิ่มงานเมื่อ Regression set ผ่านและ Receipt ตรวจสอบได้
เรียนสร้าง Agent ที่ส่งงานได้ ไม่ใช่แค่ Demo
ใน Workshop Claude Code + Cowork เราสอนตั้งแต่ AGENTS.md, Skills, Connectors, GitHub, Deployment และ Workflow ที่มี Schedule/Approval ผู้เรียนเริ่มจากระบบใช้งานในองค์กรหรือ Google Workspace ได้ ไม่จำเป็นต้องสร้าง Web app ก่อน
ดู Workshop Claude Code + Coworkคำถามที่พบบ่อย
Jev Harness คืออะไร?
เป็นแนวทางวาง Decision layer ภายใน Runtime ของ Agent เพื่อเลือก Context, Route, Tool และ Review โดย Host code ยังเป็นผู้ตรวจ Policy และ Execute
ติดตั้งแล้ว Claude Code หรือ Codex เร็วขึ้น 200× จริงไหม?
ยังสรุปไม่ได้ ตัวเลขมาจาก Social summary ไม่ใช่ benchmark end-to-end ที่ใช้แทนผลของทีมคุณได้ ต้องวัดกับ Task set และ Baseline จริง
Receipt ทำให้ Action ปลอดภัยอัตโนมัติไหม?
ไม่ Receipt ช่วยตรวจย้อนหลัง แต่ไม่ใช่ Signature หรือ Authorization Host ต้องบังคับ Policy, Sandbox และ Permission แยกต่างหาก
เริ่มโดยไม่ใช้ Jev ได้ไหม?
ได้ เริ่มจาก Conditional context, Tool allowlist, Approval, Build/Test และ Log ก่อน แล้วค่อยทดสอบ Decision model เมื่อมี Baseline
เหมาะกับงานอะไร?
เหมาะกับ Coding/Operations workflow ที่มีงานซ้ำ Tool เยอะ ต้นทุน Context สูง และต้องการ Audit trail แต่ไม่ควรเริ่มจาก Action เสี่ยงสูง
แหล่งอ้างอิง
- [1] Jev Harness blueprint social summary — darkzodchi on X · เข้าถึง 2026-09-28
- [2] Jev Harness repository and implementation boundaries — TypeSafeAI community repository · เข้าถึง 2026-09-28
ตัวเลขและข้อเท็จจริงในบทความนี้ตรวจกับแหล่งทางการด้านบน ตาม นโยบายบรรณาธิการ
